模块 M1
文书链工作流
把流水账变成结构化报告的完整处理链。
材料预处理:提取关键信息
知识库检索:同类报告 + 模板
报告生成:六章节输出契约
自检 + 缺失项清单
前两课分别解决了「怎么做」(技能)和「有什么」(知识库),但它们各自独立。 这节课教你把多个技能和知识库编排成一个统一的项目助理——用户只需要开口说一句话, 项目助理自动判断意图、选对技能、查对知识库、输出结构化回答。
课后自测:课后测验(13 题)→ 覆盖五个基础词与本课 3 项教学目标(助理架构 / 配置挂载 / 工作流调试),每题标注对应《学员手册》章节。
后面你会在 Agent平台 里配置项目助理。在此之前,先用几分钟扫一遍智能体、工具、接口、工作流(以及延伸概念 MCP)——它们把第 1 课的技能、第 2 课的知识库串成「能办事的助理」,而不是「只会聊天的窗口」。
围绕一个明确目标,能自主规划并执行多步任务的 AI 助理——不只回答一句话,而是把「流水账 → 抽取 → 检索 → 生成报告」这类流程跑完。
例子(绿源):用户说「帮我把这份活动流水账写成结项报告」,项目助理依次抽取关键信息、检索历史项目书、生成六章节报告并列出缺失项——而不是只回一句「好的,我可以帮你写报告」。
和聊天的区别:聊天侧重一问一答;智能体侧重多步完成目标,必要时调用工具、检索知识库,并在关键节点停下来问你。
本课对应:你在 Agent平台 里配置的「项目助理」就是一个智能体;后面的架构图、工作流与配置步骤都是在给它「加能力、定流程」。
智能体可以主动调用的外部能力——查表、读文件、生成文档、检索知识库等,相当于助理手里的「具体动作」。
例子(绿源):结项报告技能、知识库检索、信息抽取节点——每个都是智能体在流程里「伸手去用」的一项能力。
和第 1 课「技能」的关系:第 1 课写的技能,在本课被挂载进智能体,变成它可调用的工具之一;用户不必记住技能名字,智能体按意图替你选用。
本课对应:步骤 5「连接技能与知识库」——把前两课的资产挂到项目助理上。
两个系统之间按约定规则交换数据的通道——像插座与插头,让工具能连上外部服务或大模型。
例子:大模型服务提供「发送问题、拿回回答」的数据通道;知识库服务提供「上传文档、发起检索」的通道。
和聊天的区别:聊天是你直接和 AI 对话;接口是系统与系统在后台传数据——用户通常看不见,但智能体要靠它才能「真的办事」。
本课对应:Agent平台 组织层已内置大模型与知识库能力,不需自购接口;若用 QoderWork 等个人工作台深度调试,可参考课前 大模型接口开通指南。
一种标准化的连接方式,让 AI 智能体用统一格式接入各类外部工具与数据源——好比「通用转接头」,减少每家工具各写一套对接的麻烦。
例子:同一套 MCP 配置,可让智能体连接文档库、表格或内部系统,而不必为每个系统单独写插件。
本课对应:本课主线在 Agent平台 零代码编排,不展开 MCP 实操;知道它是「工具的标准连接层」即可,有技术储备的机构可在课后延伸探索。
智能体完成任务时的步骤顺序——先做什么、后做什么、哪一步必须停下来问人、哪一步可以自动往下走。
例子(绿源):M1 文书链「输入 → 信息抽取 → 知识库检索 → 生成 → 缺失项清单」;M2 案例链在写入知识库前必经「脱敏」节点。
和聊天的区别:聊天没有固定顺序;工作流把机构经验固化成管道,保证每次输出结构一致、关键步骤不跳过。
本课对应:后面的 M1 / M2 / M3 三条模块工作流,以及互测后的「改一步、测一步」迭代,都是在打磨工作流。
弄懂五个基础词之后,再花几分钟理解三个贯穿全程的核心概念——它们指导你将技能(第 1 课)、知识库(第 2 课)和系统提示词串成一个真正有用、风格一致、能持续改进的智能体。
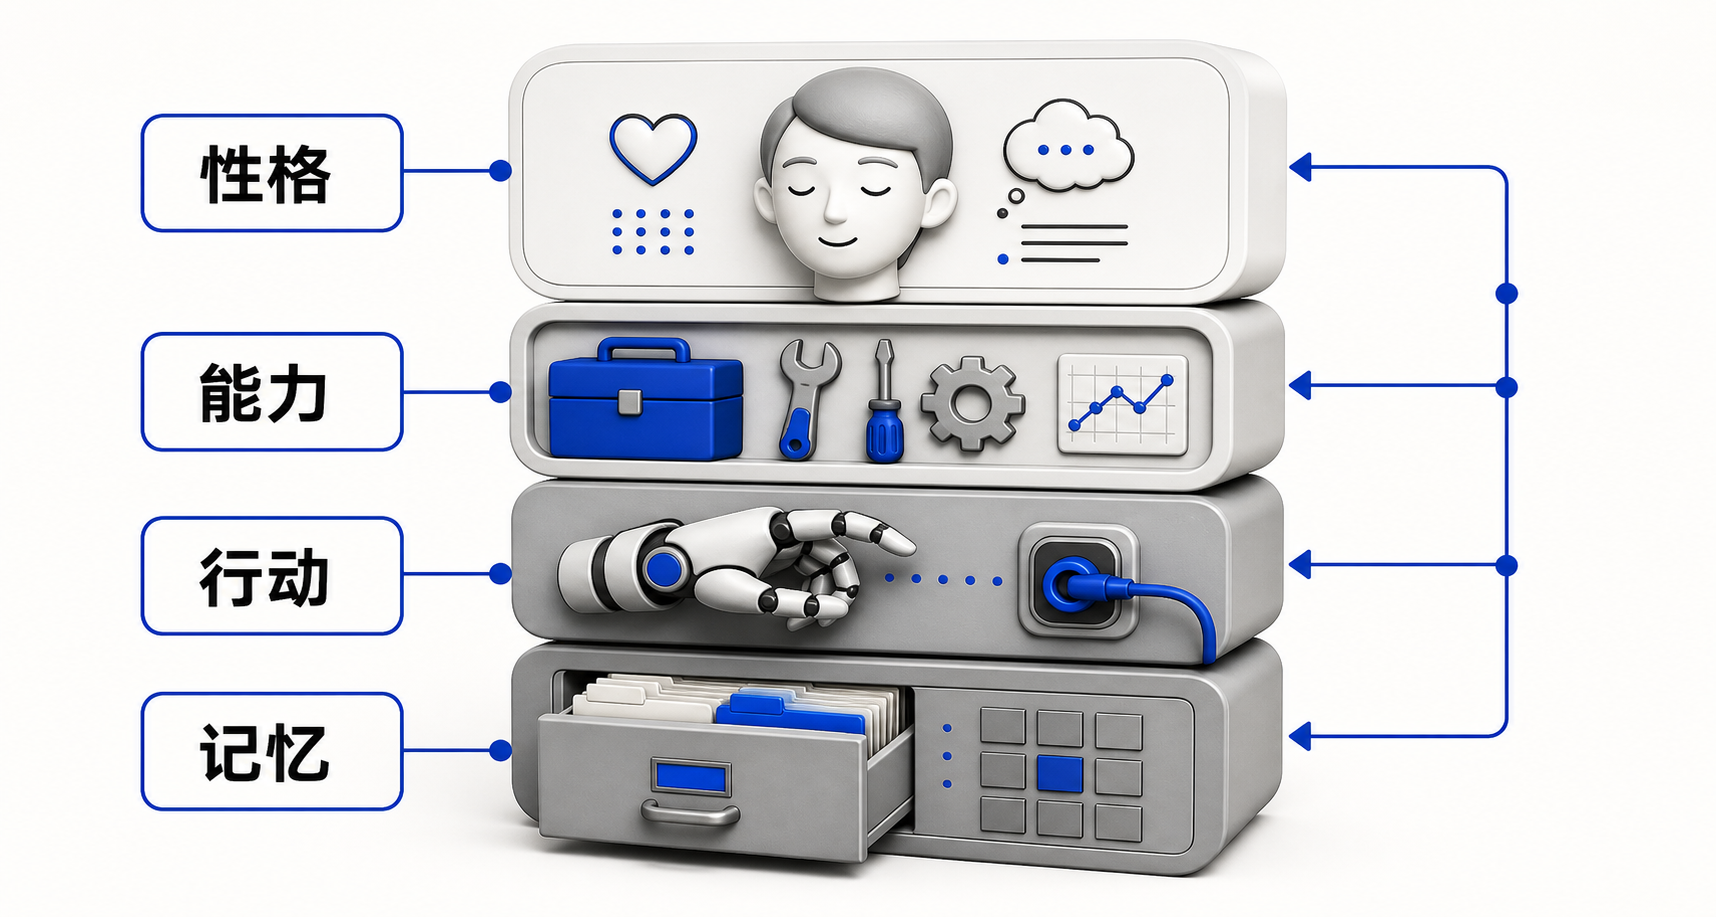
系统提示词的三个组成部分——角色定位("你是 XX 机构的项目助理")、语气(亲切但专业)、红线(不编造、不泄密)——本质上是在定义 AI 智能体的性格。
一个好的性格是一致的:不管智能体在处理结项报告还是回答知识库查询,它都保持同一身份、同一语气。公益机构特别需要注意语气的设计——过于正式像政府文书,过于随意又不像机构品牌。找到你的"机构声音"。
与前面操作的关系:本节课的步骤 3(修改欢迎语)和步骤 4(设置系统提示词)就是在做性格设计。写完系统提示词之后,你可以用"角色定位 / 语气 / 红线"三要素检验是否完整。
🧱 一个完整的智能体 = 四层编排:不只是系统提示词——它是由 系统提示词(性格) + 技能(能力) + 脚本/工具(行动) + 知识库(记忆) 四个组件共同构成的行为体。第 1 课学了技能,第 2 课建了知识库,这节课把它们和系统提示词编排在一起——你就在构建一个完整的智能体。
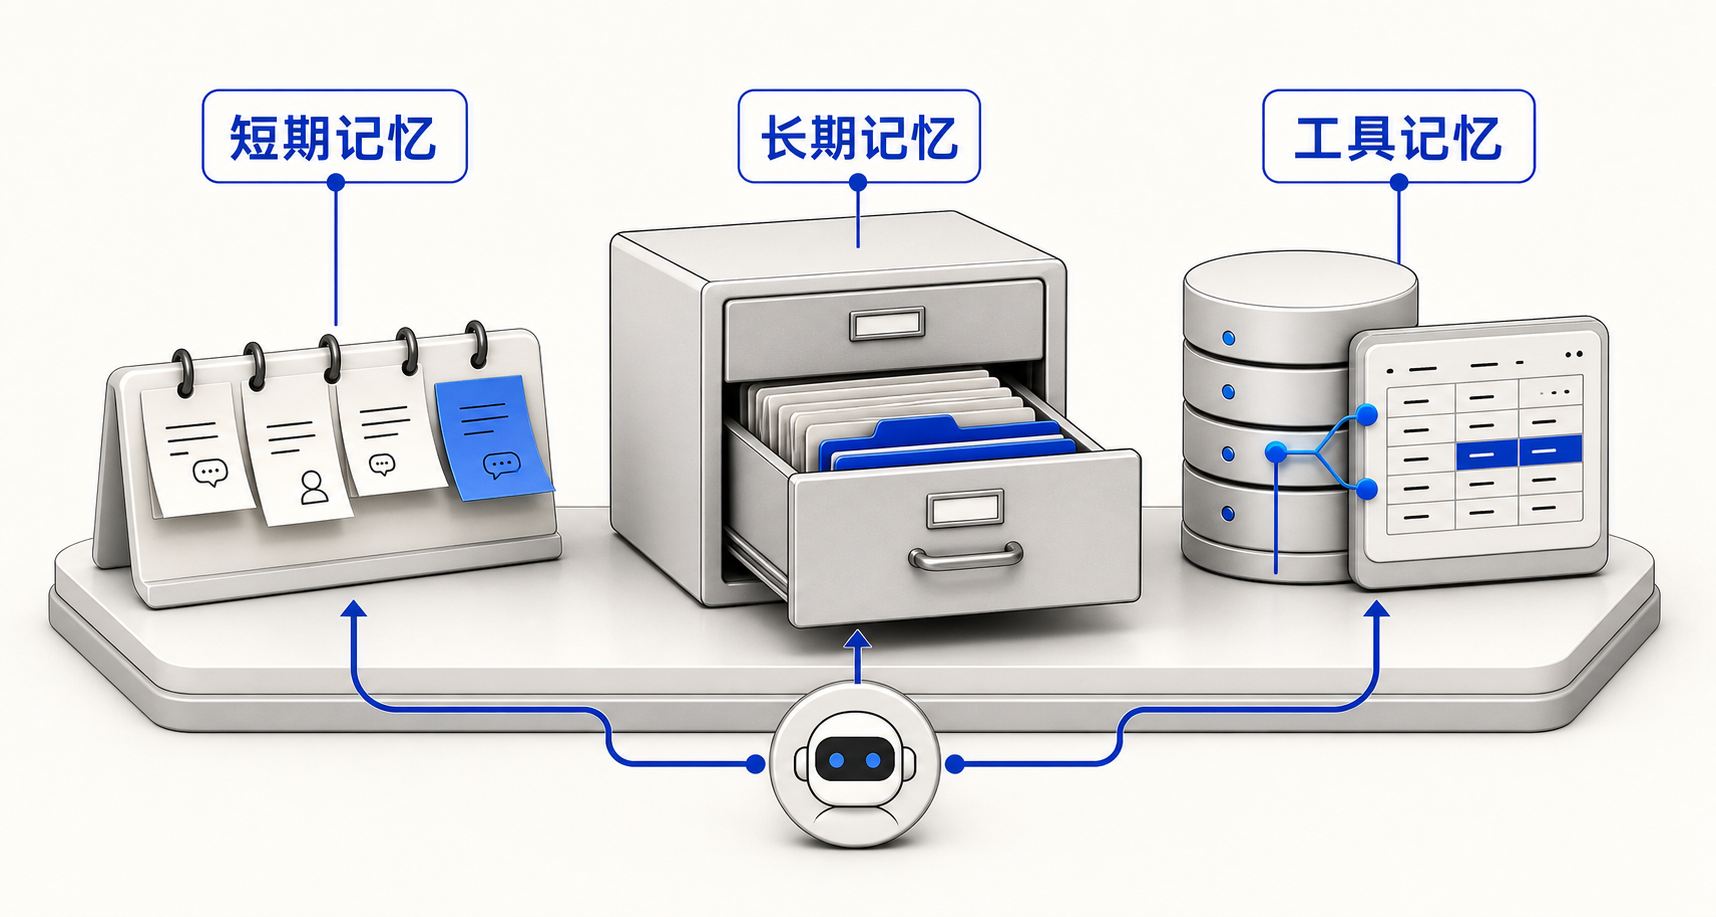
一个智能体的"记性"不是单一概念——它至少有三层,各有各的用途和限制:
第 2 课的知识库检索解决的是长期记忆——让智能体记住机构的项目、报告、案例。但学员常困惑的"为什么聊着聊着就忘了前面说的?"是短期记忆(上下文窗口)的限制——Agent平台 的对话窗口有限,超长对话中旧消息会被裁掉。
工具记忆(连接到外部数据库或接口)在基础阶段暂不涉及,但如果你需要智能体读取实时的项目数据或捐赠记录,它就变得很重要。
智能体不是"一次配好就完事"。后面的互测环节你收集了「准 / 不准 / 乱答」三类反馈——这本质上就是一次人工引导的迭代改进。
改进循环很简单:
🔍 互测反馈 → ✏️ 修改系统提示词/触发条件 → 🔄 再测 → ✅ 更准
每次循环聚焦一个最痛的「不准」或「乱答」场景,改完马上验证。不要一次改太多——改一处、测一次、看效果。这和公益项目管理中的"迭代复盘"思路完全一致。
更进阶的做法(第 4-5 课会涉及):把互测记录做成一个测试用例集,每次改完系统提示词都跑一遍,确保修了旧问题没引入新问题。
本课的主线平台是 Agent平台(零代码、开箱即用)。但如果你的机构有技术人员,或对数据自主可控有更高要求,OpenClaw + Lighthouse 是一条值得了解的补充路线。
OpenClaw 是一个以命令行为主的智能体框架,它的设计哲学和本课所学完全一致:把技能、知识库、性格编排成一个统一的智能体。和 Agent平台 的核心区别在于承载方式:
Agent平台:零代码网页端,性格写在后台文本框里,适合非技术人员日常运营
OpenClaw:性格定义是一份文件,技能和知识库也以文件形式组织——整个智能体就是一个可版本管理的目录,适合有技术人员的机构深度定制
不管走哪条路线,本课的核心概念——性格设计、三层记忆、迭代改进——是通用的。如果课后想探索 OpenClaw,可以从课前准备文档中的 大模型接口开通指南 获取起点。
用户不需要知道背后有几个技能、几个知识库——只需要一个入口,说清楚自己要什么,项目助理替你分拣、检索、组装。
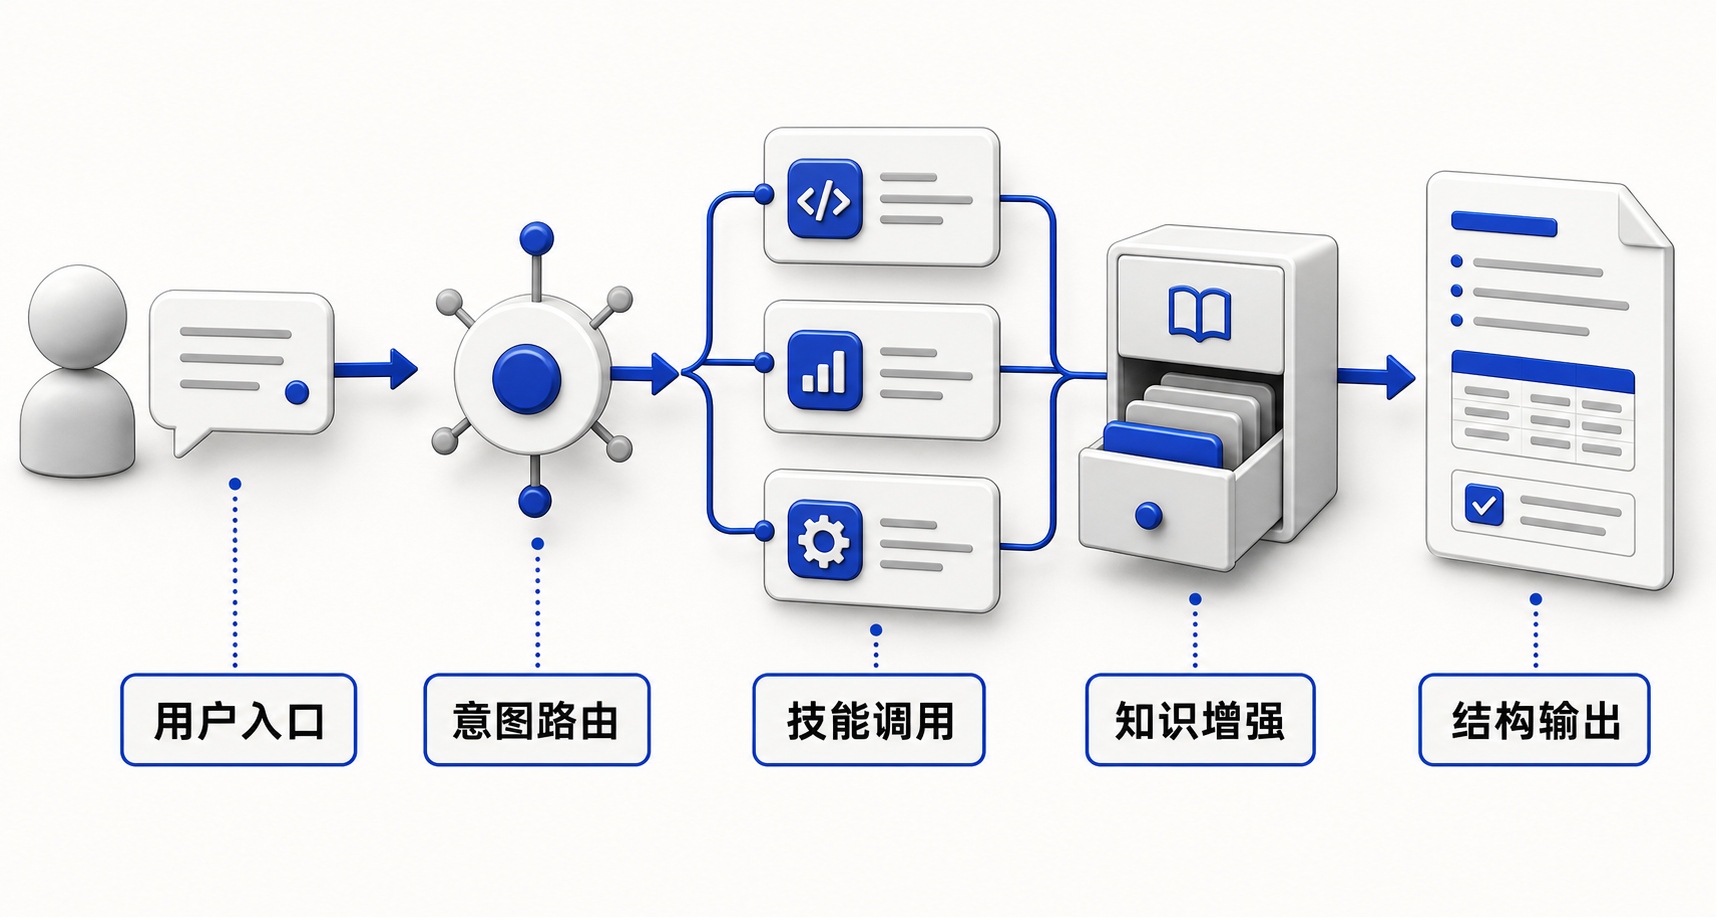
扫码 / 链接 / 嵌入网页——一个统一的对话窗口
用户说了什么 → 应该分到哪个技能?不是独立的后台设置——它就是你写在系统提示词里的路由规则。你定义了"当用户说X时走Y技能",项目助理照做。
根据意图加载对应技能的 SOP + 输出契约(结项报告 / 项目书 / 案例检索 / 推文...)
从云端知识库检索相关文档切片,补充事实、案例、数据,减少幻觉
按技能的输出契约组织回答,标注来源 / 缺失项 / 置信度
从注册平台到互测反馈,120 分钟内完成一个可对话的项目助理。
注册 Agent平台,Fork 主模板到自己工作区,自定义机构名称、欢迎语与系统提示词。
把第 1 课的技能嵌入触发条件,上传第 2 课的知识库,调试 5 个真实问题。
按文书链、案例库、传播运营三个模块,各搭建一个多步骤工作流。
扫码互测,每人问 3 个问题,记录「准 / 不准 / 乱答」。
核心思路:先让项目助理「能聊」(步骤 1-2),再让它「聊得好」(步骤 3-4)。不必一次做到完美——第 4 课会把你的主场景拆成多智能体协作链。
当简单的「意图 → 技能 → 回答」不够用时,用工作流把多步骤串起来——每个模块都是一条完整的处理链。
把流水账变成结构化报告的完整处理链。
从需求到案例卡片的精准检索链。
从素材到合规发布的内容生产链。
和邻座交换项目助理二维码,各问 3 个问题,把回答分成三类——这是发现问题最快的方法。
回答正确、格式对、引用了知识库中的真实信息,技能加载也正确。
回答了但信息有误,或编造了不存在的数据——说明知识库缺料或检索不到位。
答非所问、加载了错误的技能、格式混乱——说明意图识别或触发条件有问题。
第 3 课把技能和知识库编排成一个项目助理。第 4 课会把一个主场景拆成主控智能体、专责智能体和审核收口,用结构化交接协议完成联合工作。